文脈が失われ、誤認識が起きる
短い音声単位だけでは会話全体の意味を捉えられず、同音異義語や専門用語を誤って認識することがあります。
 SPEECH INTELLIGENCE
通話や会議を、検索・分析・再利用できる知識に変える音声インテリジェンス。
日本語と英語のリアルタイム音声・録音に対応。文脈に沿った文字起こし、話者の分離、話題ごとの整理を行います。テキストのマスキングにも対応し、会話の要点を検索・参照できる形で蓄積します。
従来の音声認識は、「音を文字にする」ことを目的として設計されています。
しかし、実際の会話には、ノイズ、言い淀み、同音異義語、専門用語、固有名詞、数字、複数言語の混在など、認識を難しくする要素が多く含まれます。
短い音声単位だけでは会話全体の意味を捉えられず、同音異義語や専門用語を誤って認識することがあります。
話者の識別、フィラー除去、文章整形、重要箇所の抽出など、分析前に多くの前処理が必要です。
音声データには個人情報が含まれ、文字起こし結果も長くなるため、そのままではRAGや生成AIで扱いにくいのが実情です。
音声を文字へ変換することがゴールです。
従来の音声認識は、主に声の音響的な特徴から文字の候補を推定します。前後の文脈を踏まえた判断には限りがあり、同音異義語の多い日本語では誤認識につながりやすくなります。
文字起こしは、ゴールではありません。
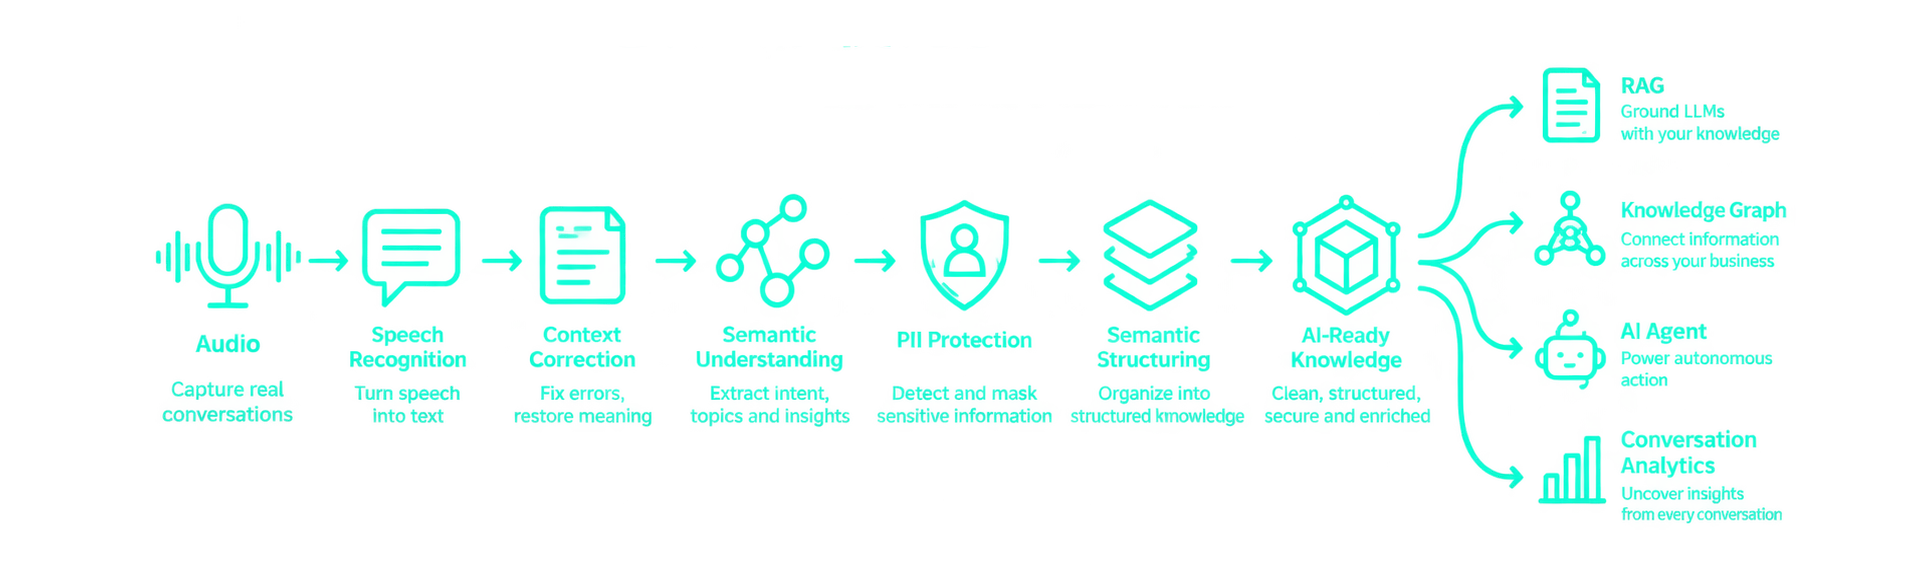
AIKNOW Voiceは会話の文脈と意味を理解し、音声から企業が利用できる「ナレッジ」を生成します。
← 横にスクロールできます →
長い会話の文脈を保持し、意味的な推論によって同音異義語や曖昧な発話を補正します。生成AIで文字起こしを補正し、原文字起こしも保持します。補正には誤りが生じ得るため、重要な内容は原記録と照合します。
専門用語や固有名詞に加え、日本語の会話に英語が混ざる場合や、電話番号などの数字にも対応します。
話者を識別して各発話を分離します。「えー」「あのー」などのフィラーや不要なノイズを処理し、読みやすい会話データへ整えます。
住所、電話番号など、設定した対象情報を文字起こしテキスト上で検出・マスキングします。音声そのものは対象外です。検出品質はサンプルテストで確認します。
固定文字数ではなく、話題、意味、重要な発言のまとまりに基づいて文字起こしを自動分割します。
整形・構造化した結果は自動で利用し、RAG、ナレッジグラフ、会話分析へ接続できます。AI学習への利用は、目的とデータの取扱条件を別途合意します。
顧客との通話を文字起こし・構造化し、問い合わせ内容、クレーム、対応プロセス、オペレーター応対などの分析に活用できます。
会議内容を記録するだけでなく、重要な議論、アクション、担当者、期限を整理します。AIが担当や期限を推定する場合は、発言に基づく情報と区別して示し、必要に応じて確認します。
応対内容を分析し、規定違反や誤案内の確認を支援。テキストのマスキングとアクセス管理を組み合わせ、内部レビューや監査での利用を支援します。
通話、会議、サポート履歴など、これまで検索・再利用が難しかった音声データをRAGやナレッジグラフへ統合し、企業のナレッジ資産へ変換します。
録音環境、日本語・英語の利用状況、用途をお聞かせください。代表的な音声で、文字起こし、テキストのマスキング、情報の整理を評価し、業務への活用を検討します。
音声解析のデモ・検証を相談する